東京大学SPH(公共健康医学専攻)を卒業しました。
2026年3月24日 東京大学SPH(公共健康医学専攻)を卒業し、
MPH(Master of Public Health)/ 公衆衛生学修士を取得しました。
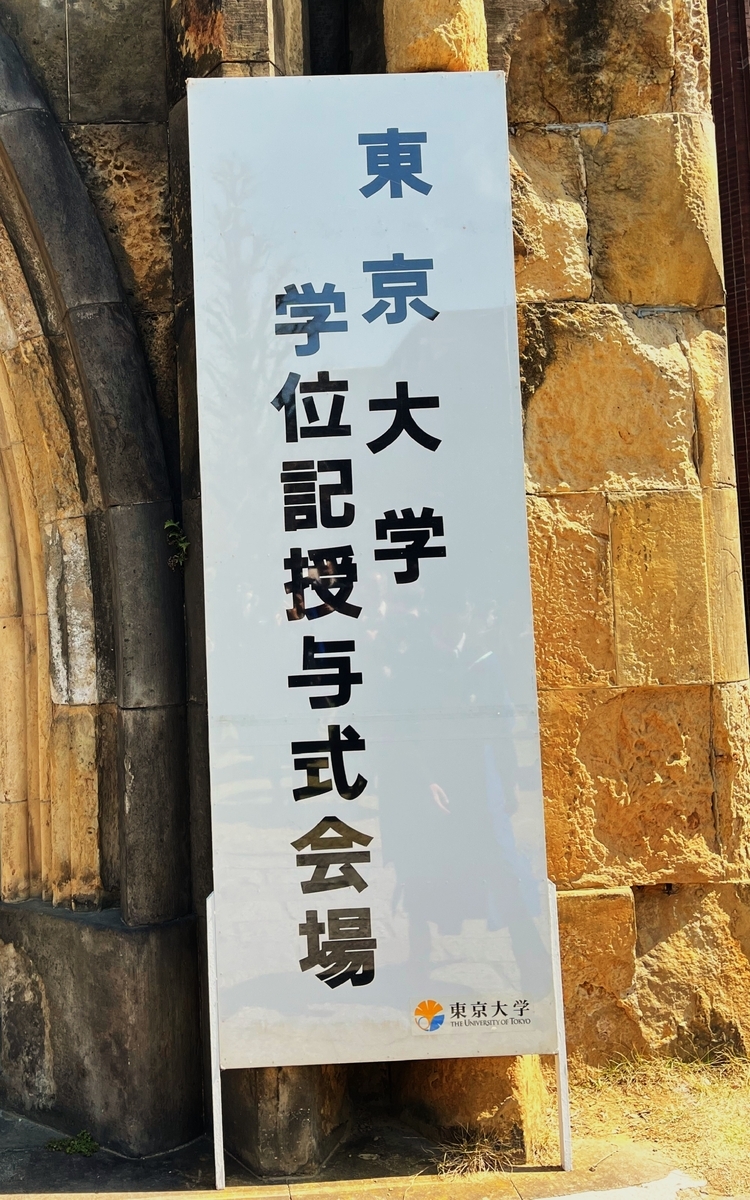
↓ 入試~入学からあっという間の充実した学生生活でした。
以下の3点から、東大SPHでの1年間(私は1年コースでした)を振り返ります。
・視野の拡張
・社会を変えること
・一流の方々との出会い
・視野の拡張
この1年間で教員の先生方、同期の学生から様々なことを学ばせていただきました。
まず、講義ですが、東大SPHでは公衆衛生に関わる様々な分野の基礎を学ぶことができます。東大SPHを目指す方(特にMD?)には、疫学・生物統計・リアルワールドデータ解析に主な関心がある方がいるかと思います。私もそうでした。しかし、そんな方こそ、医療政策・経済・コミュニケーション・社会学・教育学等の分野を学んでいただきたい思います。人々の健康に貢献するには、病院の中だけでは限界があること、エビデンスさへあればいいというわけではないことを理解することができると思います。社会(人)は不確実で、それぞれ異なる文化や価値観(思想)を持ちます。
教員の先生方、同期の学生の方々は様々なバックグラウンドがあり、病院の中で臨床医をしていた経験しかない自分には無い視点を学ばせていただきました。多くの講義で質疑応答・意見のやりとりが行われ、講義の時間内では足りないこともあるほどです。講義自体はもちろん、そのディスカッションから学ぶことが多いです。
これらの学びを通じて視野が広がり、世界の見方が1年間で大きく変わりました。少し恐ろしいほどです。
・社会を変えること
人々を健康にするには、行動変容を起こす必要があります。これまで様々な研究が行われ、何が健康に良い・悪いというエビデンスが毎日のように更新されております。しかし、なかなか社会全体は変わりません。つまり、データを使ってエビデンスを作るだけでは、人々を健康をするには足りないのです。健康になるには野菜を食べた方がいい、運動をした方がいいということはほとんどの人が知っていることでしょう。でもなかなかそれができません。それは自己責任でしょうか?.... また、こうすれば解決できそうというアイデアはいくつか浮かぶかもしれませんが、それは格差を広げないでしょうか?それを実装するにはどうすればいいでしょうか(エビデンスを作ったその先は)?どのように伝える・意思疎通すればいいでしょうか?
東大SPHではこれらを研究・実践する教員の先生および外部から招かれた実務家の方々のお話を聞くことができます。
・一流の方々との出会い
東大の先生方には圧倒されます。とても近づくことができないと思わされるような超人的な能力を持たれているように感じることもあります(もちろん皆様とてつもない努力をされているかと思いますが)。ただし、この方向で自分も努力をすればいいんだなという学びがあります。また、同じ研究室の研究者の方々やSPHの同期にも尊敬できる方が多く、自分とのギャップを認識することで、今後の自身の成長のための指針を立てることができたと思います。
・
・
・
今後、私は新たな領域に挑戦をします。臨床医という立場ではなくなりますが、自分ができることを活かして社会に貢献していければと思います。
因果推論 IPTW-MSM G-formula の考え方
因果推論におけるIPTW-MSMやG-formulaを勉強。
G-methodsの3つの内、比較的理解しやすい2つ。
傾向スコアを用いたIPTW「傾向スコアの逆確立で重み付けすると交絡の影響を排除できる」くらいの理解のレベル感から一歩進もうと思います。
IPTW(MSM)、(更にG-formulaも)は時間依存性変数の文脈で出現しますが、いずれも時間依存ではない(Fix)交絡への対処でも用いられます。
なにがしたいのか? ⇒ 交絡の影響を排除したい、Exchangeabilityを獲得したい。
・IPTW-MSM
IPTWを用いて交絡の影響を排除した擬似集団を作ります。
疑似集団の作成のためにPSの逆確立で重み付けします。
これによって周辺分布が作れる(と言っていいのか?)。
この疑似集団においてアウトカムモデルを用いることで交絡を気にせずATEを求められる(重み付きのモデルを使用)。
ただし、ロバスト分散orBSでCI計算必要(同一個人へ重みを適用するため)。
アウトカムモデルに依存しない利点がある一方で、暴露モデルに依存する。
continuous treatmentがあるとdensityの推定に結局は仮定が必要。
Time-varyingでは時点毎の重みのΠなのでバイアスが増幅される。
Stabilizedの方が重み安定するとされるが、それでも安定するとは限らず、positivityを評価したり、必要に応じて重みの加工が必要(Stabilized weightに至る過程はSWIGによって表現できる)。Satured modelではStabilizedとUnstabilizedは一致するらしい。
Satured modelって結局なんなん。。。
相互作用の評価には使いにくいようですが、この辺りは勉強不足です。
ATEだけでなく、ATTを求めることもできる。
コーディングはシンプルな設定なら各時点の治療に対するモデリング⇒掛け合わせ。打ち切りがあれば、打ち切り重みも考慮。
Weightの分布の評価と必要に応じてTrimingやTurncationする(感度分析)。ただし、これやると結局Marginal なんですか?という疑問はある。
・G-formula(parametric)
普通の層別解析はその層の効果しかわからない
⇒ 標準化により集団全体効果を推定できる
⇒ 層が多いときやLが連続変数では困難
⇒ 回帰モデルによる標準化≒g-computation
(回帰モデルは誤設定なければ、回帰係数⇒conditonal ATE=marginal ATE)
成書によっては通常の標準化の式をTime-varyingを扱えるよう一般化したもの(history of Time-varying covariatesを加えたもの)をg-formulaである、としている。
まずデータを一個人に対して時点毎の行を持つ形にする。
アウトカムモデルを作りパラメタ推定する。
このときに交絡に対するモデルも作る必要がある。
Time-varyingな変数に対してはChain ruleを使い、逐次的に確率を積み重ねることになる。ここが肝になる部分であり、同時に誤設定リスクがある。
実際にどのようなモデルを作るのかはまだまだ勉強中だが、どれくらい過去の変数まで影響を考慮するか等を考える必要がある。
次にAlways treatとNever treatな仮想集団を構築する。(他のパターンも考えること可能)
その集団に対して上記で構築したモデルによりアウトカムモデル予測を行う。
求まった個人毎のアウトカム予測値を用いて群別の平均差からATEを求める。
・
・
・
g-null paradox 偽陽性 実際には影響少ない?
それぞれ仮定があり、誤設定リスクがある。➡Doubly robustへ。
また、これらはCounfouningの話なので、因果推論の一部であり、TTEなどの理解が必要。
完全に余談ですが産婦人科の最も権威のある雑誌(所謂Green Journal)のInstructions for AuthorsでPSMを交絡調節の代表例みたいな感じで推奨しておりす。PSMの流行りの影響はあるみたいですね。この記事が示すようにPSMやればRCTを模倣できるわけではないです。
産婦人科専門医試験のCBT化
日産婦から「産婦人科専門医認定二次審査における CBT試験について」と題したアナウンスが先日ありました。


筆記がCBT化するだけであり、試験内容の変更は文面からは読み取れません。
以前より記載のある「総合点に関らず知識が偏っている場合は不合格となることもあります」については改めてご注意を。
以下、抜粋 (引用:日産婦誌77巻 5 号)
CBT試験では選択肢問題を120問出題する予定です.
出題範囲は学会が定めた「産婦人科専門研修における到達目標」に基づいており,婦人科腫瘍,生殖・内分泌,周産期,および女性ヘルスケアの4分野のほか,感染対策,医療倫理,医療安全や医療保険制度に関するものも含みます.
出題基準は産婦人科専門医に求められる知識および技能とします.
⃝産婦人科専門医として最低限必要な知識レベルの客観的評価を目的に実施します.
⃝総合点に関らず知識が偏っている場合は不合格となることもあります.
なお,CBT試験に関するお知らせは今後も本会の機関誌やホームページに掲載する予定ですので,ご参照下さい.
2025 年度
CBT試験 2025年7月26日(土)
面接試験 2025年7月27日(日)
2026 年度
CBT試験 2026年7月25日(土)
面接試験 2026年7月26日(日)
※ 上記の試験内容や日程については現時点で筆者が確認したものであり、受験者は必ず自身で最新情報を確認するようお願い致します。
論文のReference(参考文献)のスタイルを整えよう
馬鹿にできない論文のReference(参考文献)の書き方をまとめます。
時短でやろう でも正確にやろう
論文を書く過程の中でここの作業はなるべく時短で済ませ、他のことに労力を割きたいです。よって、ここは所謂タイパが求められるパートです。
しかし、査読者はReferenceの体裁を注意深く見ております。
Referenceが整っていないと印象が悪くなります。
ここは加点はされませんが、減点されるパートだと思いますので注意しましょう。
ソフトを使おう でも目視もしよう
ソフトはなんでもいいと思います。
Mendeley・Zoteroなど無料のものがあります。(私はZotero派)
また、Paperpileは使いやすいですが有料です。
これらの使い方はYoutubeやネットに解説がたくさんあります。
ただし、投稿したいジャーナルのスタイルがそれらのソフトに採用されていないことがよくあります。さらに、そのジャーナルのスタイルを選択しても上手くいないことがあるので鵜吞みにしないことです。ソフトを使っても完璧にはならないことが経験上多々あります。
重要なポイント
必ずジャーナルの投稿規定のReferenceセクションを確認しましょう。
ジャーナルによってはあまり詳しく書いて無いこともあります。
同時に、そのジャーナルから出版されている最近の論文を複数チェックしましょう。
複数というのがポイントです。なぜなら、意外と雑誌から出版されている論文の中にはジャーナルの投稿規定に沿っていないReferenceのスタイルのまま出版されていることがあるからです。
具体的な注目ポイントの一部
著者A, 著者B, 著者C, et al. 論文名. 雑誌の略称. 年巻号ぺージ. doi: ~~~
・著者:ジャーナルによって著者を何人まで記載するのか様々です。
7人以上のときは3人まで記載するor6人まで記載するなど。
・ピリオド:「雑誌の略称.」「 雑誌の略称」とピリオドが付くものと付かないものがあります。
特に良くないのは、同じ論文の中でピリオドが付いてたり、付いて無かったりバラバラなパターンです。
・雑誌名:文献ソフトに取り込む時に雑誌名が略称になってないことがあります。
略称はPubmed等で確認するのが正確です。
さらに斜体なのかどうかなど違いもあります。
・年巻号:書き方は様々です。
例えばページでは71ページから78ページのときは2パターンあります。
①「71-78」 ②「71-8」
後者は71と78で10の位が変わらないので書かないタイプです。100位も同様です。
・DOIまで入れるかどうか。
・論文ではなく、教科書やホームページを引用する場合はソフトで上手くいかないことが多いので、やはりそのジャーナルの直近の既報を見るのが良いです。
印刷して最終確認しよう
モニターで見ても細かなミスに気が付かないことがあります。
紙で印刷して確認することでミスの検知をしやすくなる印象があります。
生成AIは使える
Chat GPTなど生成AIで整えることもできます。
ただし、しっかりプロンプトで指示する必要があります。
個人的な使いどころは文献ソフトに引用スタイルとして近いもの見つからないときです。
またミスがないかのダブルチェックにも使えるでしょう。
個人的な査読経験からReferenceがしっかりしている論文は内容もしっかりしているような印象があります。因果関係かは不明ですが、相関はあると思います。
CSVファイルをExcelで開くと文字化けする【データクリーニング・前処理】

データクリーニング・前処理におけるピットフォールとして
があります。
これスモールデータならExcelでCSVファイルの中身を眺めることが気が付くことができるかもしれませんが、大きなデータでは文字化けしていることに気が付けない可能性があります。
(そもそも大きなデータをExcelで開くこと自体が重さ・効率の面で好ましいとは言えなさそうなのですが)
なので以下の問題が発生することに注意が必要です:
CSVファイルをExcelで開く→文字化けする→気が付かずに上書き保存する→文字化けしたデータで解析を進めてしまう
やはりデータは統計ソフト(RやSTATAなど)で扱うのが効率的かつ安全かもしれません。
ただし、統計ソフトでデータを読み込んでも文字化けすることがあります。
多くは文字コードの問題だと思うので、適切に文字コードを指定すれば解決するでしょう。
文字化けに気が付くにはデータの要約統計量、可視化(箱ひげ図やヒストグラム)、欠損確認が重要です。
余談:一応以下のような対処法はあるようです。
Excelで文字化けさせずにCSVファイルを開く方法 | パソコン工房 NEXMAG
発表や論文で『円グラフを使うな!』という意見について考えてみます

発表や論文で『円グラフを使うな!』という意見があります。⇩
Here’s why you should (almost) never use a pie chart for your data
でも巷では円グラフはたくさん見ますよね。
学会に参加すればどれほど見ることか。。。
新聞やネット記事でも度々みます。
そこで『円グラフを使うな!』という意見について検証していきたいと思います。
円グラフの問題点
(Here’s why you should (almost) never use a pie chart for your dataからi一部引用・改変)
- 3つ以上のカテゴリがある場合、誤解を招き、読みにくくなる
-いくつかカテゴリの中でどれが一番大きいのかをに判断するのが困難
-グラフの中で共通の基準点を持たないため、占める領域が比較しにくくなる
-隣り合っていないカテゴリーは比較しにくい
-数十あるカテゴリを1つの円にまとめると、解釈が非常に難しい
-色によってカテゴリーをわけると色覚異常がある方には不利であったり、白黒印刷に耐えられない

↑ 確かに見難い。白黒印刷したらより厳しい。これなら他の図の方がいいですね。
- 3次元の円グラフを使用すると、データの誤解はさらに深刻化する:
同じ割合であっても、グラフをみる角度によって、異なる大きさに見える。 - 3D円グラフの問題はこのショート動画が非常にわかりやすいです:- YouTube
円グラフの代替手段は?
「棒グラフ」
これなら大小が判断しやすい。なぜなら同一の基準点があるから。

円グラフを使うべき時はあるのか?
- いくつかのカテゴリしかなく(2-3個のカテゴリー)
割合が明らかに異なる場合には、円グラフが適していることもある
結論
- わざわざ円グラフを使う場面は限られそう
- 事情がなければ円グラフに拘る必要はない
参考:
Snipping Toolのサイズが大きい、重過ぎ、容量を圧迫している
なんかパソコンが重い
原因を見てみるとSnipping Toolのサイズが異常に大きい、容量を圧迫している
普通の解決策としてはSnipping Toolで保存した先の画像や動画を整理整頓することなのだろう
しかし、かなり消したはずなのに全然サイズが減らなくて困った
色々いじっていたら⇩で解決した
アプリ>Snipping Tool>詳細オプション
リセットをする

